La guerre des tokens : moins de cycles, des cycles plus efficaces
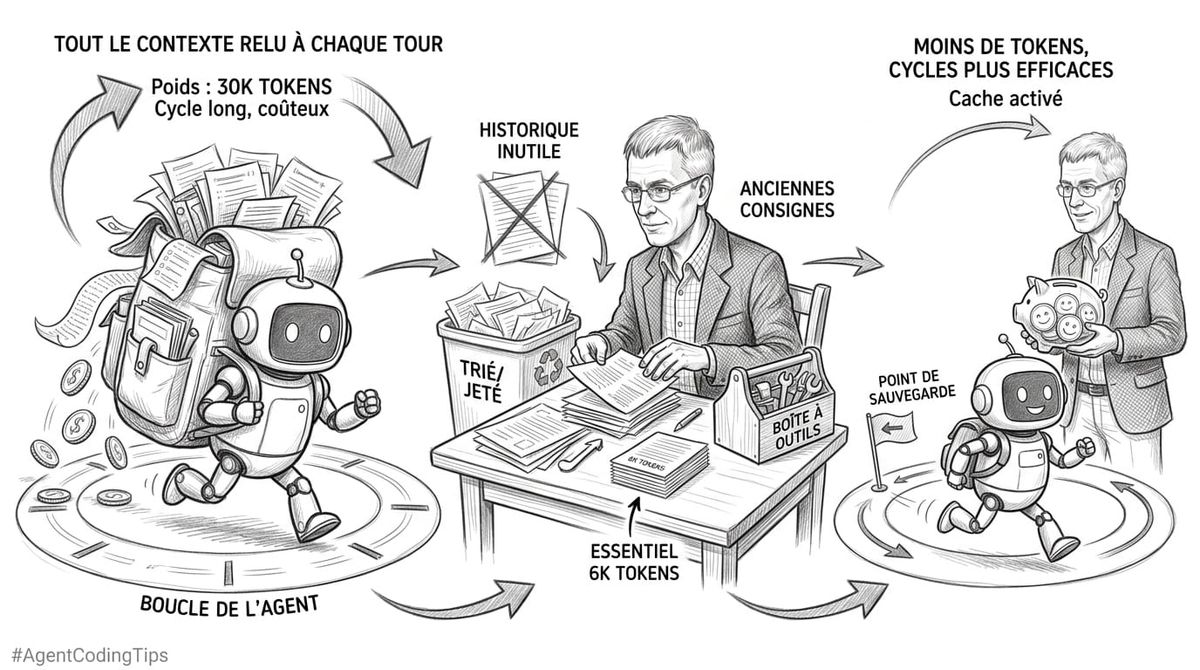
Un agent de code ne coûte pas cher parce qu'il écrit beaucoup, mais parce qu'il relit tout, à chaque tour. Le 12 octobre 2026, à la première édition de Dev With AI, j'ai présenté « La guerre des tokens » : 30 minutes pour reprendre le contrôle de sa facture LLM sans dégrader la qualité des réponses.
Cet article en reprend l'essentiel. Toutes les stratégies tiennent sur une page A4, à télécharger en fin d'article.
Où partent les tokens
À chaque tour de boucle, l'agent renvoie au modèle tout son contexte : le prompt système, la description de chaque tool, de chaque MCP et de chaque skill, les AGENTS.md utilisateur et projet, les rules, le style de sortie, la mémoire, puis tout l'historique de la conversation. Viennent ensuite la réflexion et la réponse, puis les résultats des outils (Read, Find, Bash, Write), qui s'ajoutent au tour suivant.
Optimiser, c'est donc agir sur trois leviers : ce qui est injecté en permanence, la façon dont le modèle génère, et ce que les outils lui renvoient.
Alléger le contexte fixe
Tout ce qui est injecté à chaque tour se paie à chaque tour. La règle est simple : ne garder que ce qui sert.
- MCP : limiter la liste à ceux réellement utiles, et choisir des MCP qui rendent un service complet en une seule invocation, avec un résultat court. Un simple wrapper d'API est à proscrire. Faire le choix au début ! Sinon, vous devez payer pour l'ensemble de l'historique. Le cache n'est plus valide.
- AGENTS.md : au niveau utilisateur, les préférences personnelles ; au niveau projet, uniquement ce qui est spécifique au projet. Pas de considérations génériques sur le style d'un langage : les LLM savent déjà coder.
/doctoraide à l'améliorer. - Rules : des fragments injectés seulement quand une condition est réunie, par exemple selon le type de fichier (mes règles spécifiques pour ce langage par exemple).
- Skills : une description réduite à « à quoi il sert et quand l'utiliser », un corps limité à l'objectif, aux ressources et aux paramètres des scripts. Les listes d'étapes sont inutiles avec les derniers modèles.
- Mémoire : elle consomme des tokens, à amortir en évitant les boucles et les impasses, et en la mutualisant sur le projet.
- Historique : quasi gratuit tant que le cache joue, mais au-delà de 50 % de la fenêtre de contexte le modèle entre dans une zone de grande confusion.
/clearet/compactsont là pour ça.
Régler la génération
Les tokens de sortie et de réflexion sont les plus chers. Deux réglages changent beaucoup la donne.
- Modèle et effort : ajuster
/modelet/effortà la tâche. Un gros modèle avec un effort faible fait souvent mieux qu'un petit qui réfléchit longtemps : il a plus de bon sens. Dans le doute,/model opusplanutilise Opus pour planifier et d'autres pour exécuter. - Output style : un style « Caveman » rend les réponses télégraphiques. Le même principe sert à compresser les
AGENTS.md, les skills et les descriptions. Il n'agit pas sur la réflexion ; pour aller plus loin, Headroom compresse juste avant l'appel à l'API.
Outiller l'agent et réduire les cycles
Chaque résultat d'outil grossit le contexte des tours suivants. Il faut donc des outils qui renvoient peu, et moins de tours.
- Find : par défaut, l'agent cherche avec
findetgrep. Un MCP d'indexation (/ide, ast-grep, un LSP, une recherche floue) trouve mieux et plus court. - Bash : compresser la sortie des commandes (RTK, Snip, Token-saver), et ne pas laisser le LLM faire les calculs. Un calcul sur des nombres de 5 chiffres coûte 96 tokens de réflexion, 510 pour 10 chiffres : le coût croît à peu près comme n².
- Write : modifier fichier par fichier est inefficace pour renommer un symbole.
/ideoffre des opérations de haut niveau ; en CI/CD, un MCP comme Serena joue ce rôle. - La boucle : combiner les commandes dans un script, suivre en direct et couper dès que ça dérive, installer les CLI dont l'agent a besoin, formater le code par des hooks. Et surtout, plutôt que de râler et demander des corrections, revenir en arrière et ajuster le prompt : on évite l'ancrage.
Le cache : pourquoi revenir en arrière paie
Pour produire chaque token, un LLM s'appuie sur un dictionnaire clé/valeur : la clé dit de quoi on parle, la valeur porte la connaissance sur ce sujet. Cet état est calculé pour chaque token, et le reconstruire impose de tout relire.
Le prompt caching évite ce travail : l'état est sauvegardé régulièrement, indexé par le hash du prompt. Quand un prompt arrive, le fournisseur repart du point sauvegardé le plus proche de la fin. C'est pour cela qu'un historique stable coûte peu, et que revenir en arrière est bien plus efficace que se battre pour corriger une erreur. Un simulateur permet de voir le cache à l'œuvre.
Les grands principes
Toutes ces techniques reviennent à quatre principes :
- Moins de cycles.
- Des cycles plus efficaces.
- Des informations sélectionnées, les plus utiles à la tâche.
- Ne pas laisser le LLM chercher des contournements : régler le problème une fois pour toutes.
Téléchargez le cheat sheet : l'ensemble des stratégies et des outils cités tient sur une page A4, à garder sous la main pendant vos sessions avec un agent de code.
Pour aller plus loin, mon outil kompress-tokens compresse AGENTS.md, skills et descriptions.